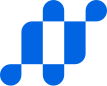
Cạm bẫy: chữ "Layers" trong công thức KV
Công thức KV = 2 × Layers × KV_Heads × Head_Dim × Seq × Batch × Precision
chỉ đúng khi mọi layer đều là full attention. Model 2026 hầu hết không như vậy.
Bốn kiến trúc phá vỡ công thức
| Kiến trúc | Cơ chế | KV cache thật |
|---|---|---|
| Sliding window | phần lớn layer chỉ nhìn window token gần nhất | hằng số khi seq > window |
| Linear attention | thay attention bằng recurrent state (DeltaNet) | hằng số |
| Mamba-2 / SSM | state space model | hằng số |
| MLA | nén KV thành latent vector | tuyến tính nhưng nhỏ hơn nhiều lần |
Điểm chung: phải áp công thức riêng cho số layer FULL ATTENTION, rồi cộng state hằng số của các layer còn lại.
Sai bao nhiêu lần?
Bảng dưới giữ nguyên kv_heads và head_dim thật, chỉ đổi
từ số layer full attention sang tổng số layer — để cô lập đúng một lỗi.
| Model | Kiến trúc | B/token thật | Nếu dùng tổng layer | Phóng đại |
|---|---|---|---|---|
| Gemma 4 31B | Sliding(1024) + global | 81.920 | 983.040 | 12× |
| gpt-oss-120b | Sliding(128) + full | 36.864 | 73.728 | 2× |
| Qwen3.5-35B-A3B | Linear + full | 20.480 | 81.920 | 4× |
| Nemotron 3 Super 120B | Mamba-2 (8/88 layer) | 8.192 | 90.112 | 11× |
| Mistral Small 4 119B | MLA (256+64) | 23.040 | 589.824 | 26× |
| Kimi K2.5 | MLA (512+64) | 70.272 | 1.998.848 | 28× |
| DeepSeek V3 | MLA (512+64) | 70.272 | 3.997.696 | 57× |
| Kimi K3 | MLA + KDA linear | 27.648 | 4.571.136 | 165× |
Bằng chứng từ config.json
Ví dụ Qwen3.5-122B-A10B — layer_types cho thấy chỉ 1/4 số layer
là full attention:
"num_hidden_layers": 48,
"head_dim": 256,                // không phải 128
"num_key_value_heads": 2,       // chỉ 2
"full_attention_interval": 4,   // cứ 4 layer mới có 1 full attention
"layer_types": ["linear_attention","linear_attention",
                "linear_attention","full_attention", ...]
→ 12 layer full + 36 layer linear. Chỉ 12 layer có KV tăng theo context.
Gemma 4 — hai nhóm thông số riêng
Config có cả hai nhóm trường, phục vụ hai loại layer khác nhau:
| Model | num_key_value_heads(layer sliding) | num_global_key_value_heads(layer full) | head_dim | global_head_dim |
|---|---|---|---|---|
| Gemma-4-31B | 16 | 4 | 256 | 512 |
| Gemma-4-26B-A4B | 8 | 2 | 256 | 512 |
| Gemma-4-12B | 8 | 2 | 256 | 512 |
Dùng nhầm nhóm thông số của layer sliding cho layer full sẽ phóng đại 2 lần.
Bỏ qua sliding_window: 1024 và dùng ctx cho 50 layer sliding
sẽ phóng đại thêm 10 lần nữa.